Erreurs courantes dans les prompts vidéo d’IA : 6 catégories de dépannage et méthodes de modification avec PixPix
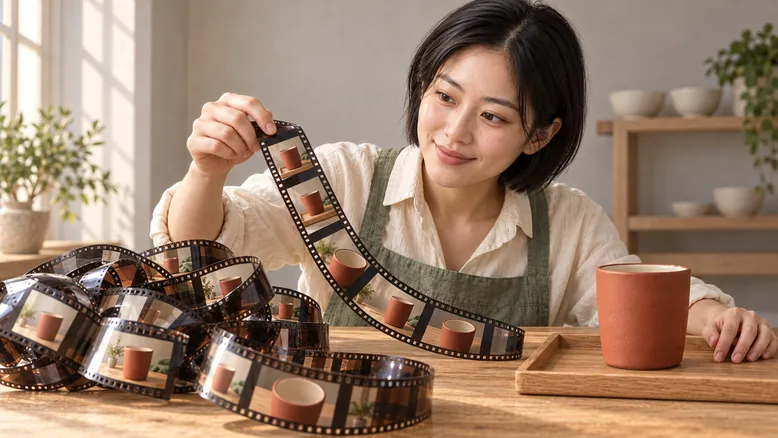
Les prompts vidéo d’IA sont souvent très longs, mais les visages des personnages se retrouvent tout de même échangés, les tasses se déforment dans la main, et un mouvement que l’on espérait voir n’est finalement filmé qu’en plusieurs plans déconnectés. Face à de tels problèmes, continuer d’ajouter des termes comme « ambiance cinématographique », « ultra‑clair » ou « qualité d’image optimale » ne résoudra pas forcément le véritable défaut.
Un point de départ plus utile consiste à décomposer la demande en trois questions : Dans quel état se trouve l’image au début ? Quels événements se produisent uniquement pendant cette phase ? Et comment considérer la scène comme terminée ? Ce tutoriel utilise l’exemple original d’un « potier posant une tasse sur un plateau » pour vous guider dans la vérification du prompt, la préparation des références, ainsi que la mise en place d’un processus de modification traçable dans PixPix.
Cet article est un tutoriel sur les méthodes de création. Les personnages et les décors présentés sont des créations originales fictives ; les illustrations sont des schémas pédagogiques statiques générés par IA. Aucune génération vidéo n’a été réalisée sur PixPix, et il n’y a ni taux de réussite mesuré, ni classement des modèles, ni garantie quant aux résultats.
Commencez par identifier à quelle étape se situe le problème
Ne rejetez pas toutes les erreurs sur le seul motif d’un « prompt trop imprécis ». Par exemple, si une tasse se déforme, cela peut provenir d’une image de référence aux contours flous, d’une obstruction trop importante de la main, ou encore d’une difficulté intrinsèque du modèle actuel à réaliser ce geste de contact.
Les écarts observés | Que vérifier en premier | Les actions prioritaires pour la prochaine itération |
|---|---|---|
Le personnage n’est pas le même dès le départ, ni la même tasse | Les références sont‑elles clairement liées et présentent‑elles une apparence cohérente ? | Remplacez les références par des éléments clairs et homogènes |
Le personnage est correct, mais le mouvement ne l’est pas | Est‑ce que l’agent moteur, le point de départ et le point d’arrivée sont bien précisés ? | Réécrivez la phrase décrivant le mouvement |
L’action de poser la tasse est bien réalisée, mais l’image change soudainement de plan | Le prompt contient‑il plusieurs angles de caméra ou plusieurs moments temporels ? | Simplifiez le tout en un seul plan continu |
La main et la tasse semblent fusionnées | Zone de préhension, occultation et difficulté du geste | Réduisez l’amplitude du mouvement et limitez les transferts entre les mains |
Malgré plusieurs générations, le défaut persiste toujours | Le modèle, le mode d’entrée et la tâche sont‑ils bien adaptés ? | Essayez d’autres modes disponibles ou modifiez la technique de prise de vue |
Ce tableau indique l’ordre des vérifications, mais ne constitue pas un diagnostic des causes des défauts. Identifiez d’abord l’élément qui affecte le plus l’utilisation, puis décidez s’il convient de modifier les références, le texte ou la conception du plan.
Établissez un état initial clair pour l’exemple original
Fixez d’abord le personnage, puis ajoutez ensuite le mouvement
Le personnage principal de l’exemple s’appelle « Lin He » ; il s’agit d’une potière fictive. Elle a les cheveux courts, noirs et raides, porte une chemise en coton blanc cassé à manches courtes retroussées, un tablier à bretelles croisées vert sauge et un pantalon gris foncé, sans aucun bijou. Tout au long de la vidéo, elle est la seule personne présente.
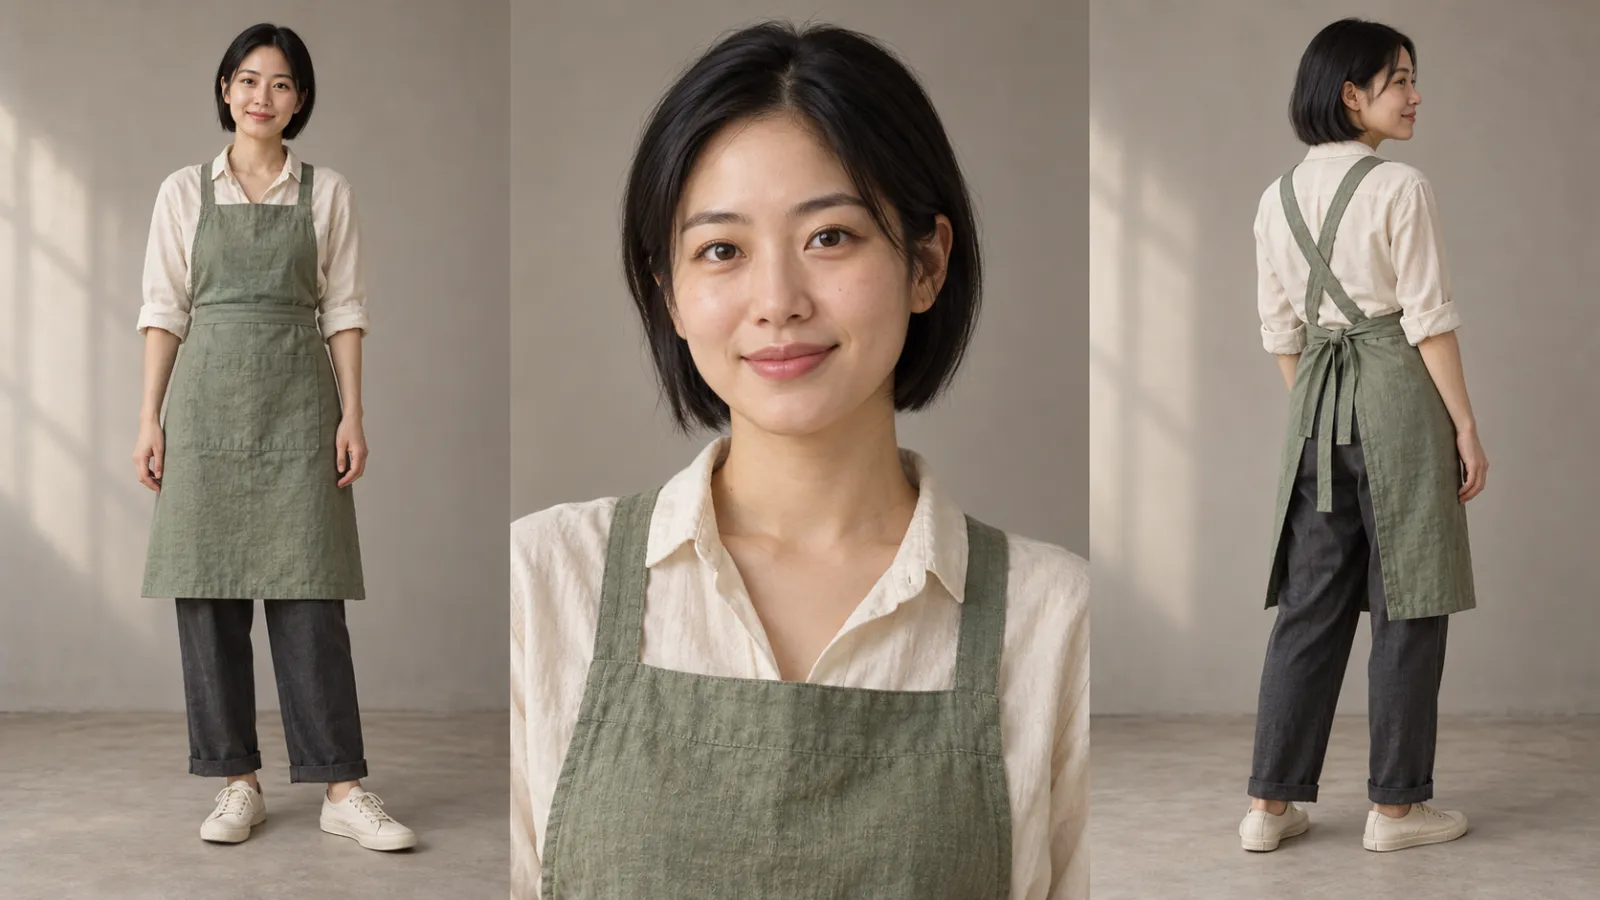
Légende : schéma illustrant les caractéristiques du personnage ; les illustrations multi‑vue ne signifient pas qu’il faut placer plusieurs portraits simultanément comme sujets principaux de la vidéo.
Les références concernant le personnage doivent répondre à deux questions : qui est ce visage et à quoi ressemble son costume ? Les plans multi‑vues peuvent aider à clarifier l’identité, mais lors de l’importation effective, il convient d’utiliser des références claires et uniques ou des références séparées selon les exigences du format, afin d’éviter que les zones représentant plusieurs personnes soient interprétées comme plusieurs individus.
Les accessoires doivent également avoir une identité unique.
Dans cet exemple, seul un gobelet en céramique sans anse est utilisé : l’extérieur est rouge ocre, l’intérieur blanc cassé, l’orifice légèrement épais et la surface mate. Il est posé au centre d’un plateau rectangulaire en chêne clair. Le plateau repose sur la table de travail et ne bouge pas durant toute la scène.
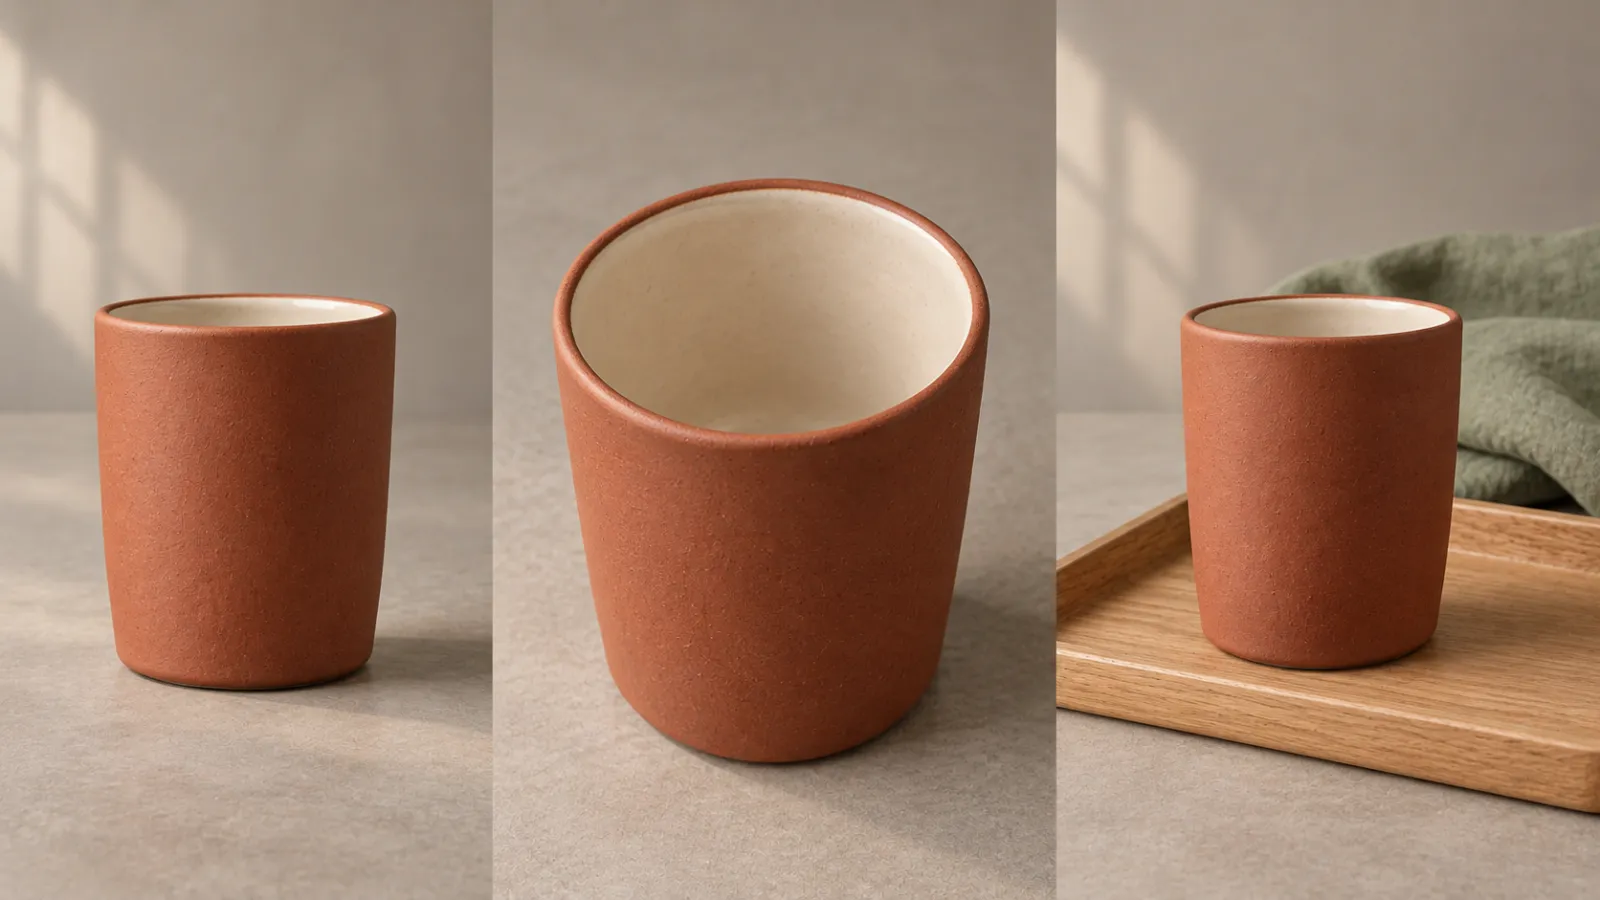
Légende : illustration conceptuelle d’un accessoire original, non destinée à valider la structure réelle du produit.
Il ne faut pas commencer par désigner l’objet comme un « gobelet en céramique » dans un même prompt, puis demander plus loin à un « mug avec anse » de se tourner vers la caméra. Si la forme, la couleur ou le motif de la surface du produit réel doivent être précis, il convient d’utiliser des photos confirmées du produit comme référence.
Transformez la scène en une configuration spatiale vérifiable.
La table de travail se trouve devant le personnage ; la grande fenêtre est située hors champ, à gauche de la caméra ; une petite étagère en bois se trouve en arrière‑droite, sur laquelle reposent trois bols en céramique blanc cassé. La lumière naturelle pénètre par la gauche, tandis que le côté droit conserve des ombres douces.
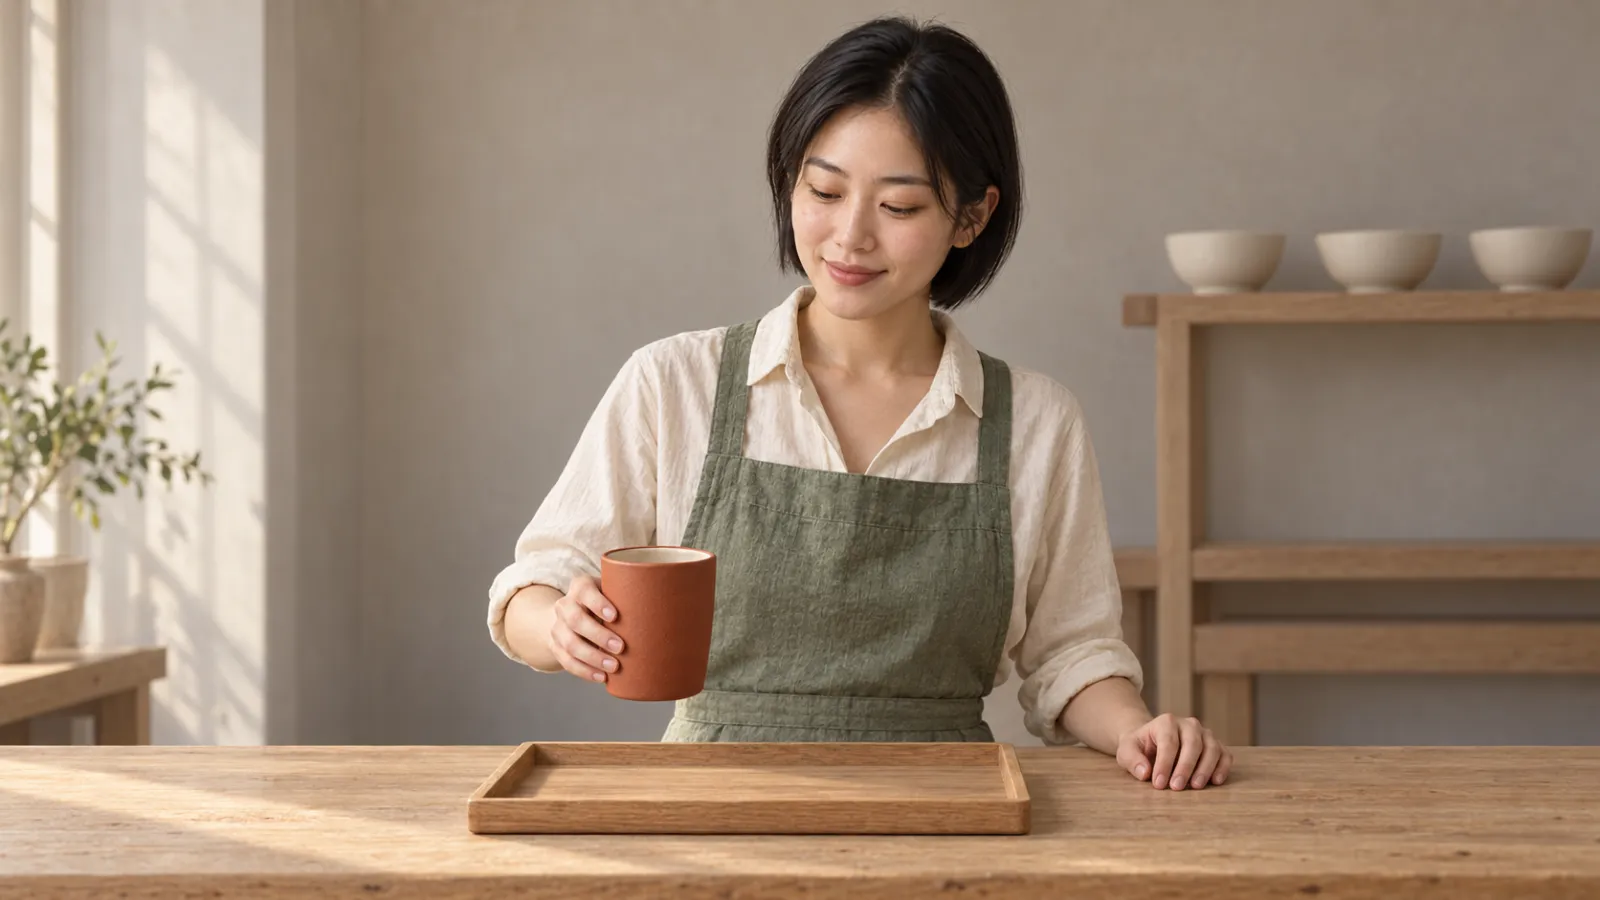
Légende : esquisse de la composition initiale : le gobelet tenu dans la main, le plateau vide.
Cette scène n’a pas besoin d’autres décorations. L’essentiel n’est pas de décrire pièce par pièce l’ensemble de l’atelier, mais d’identifier clairement les objets qui participeront aux mouvements, influenceront les occultations et façonneront la composition.
Six façons d’interpréter « poser le gobelet » pour en faire autre chose.
Écrivez uniquement une phrase promotionnelle, sans aucune action visible.
Le texte suivant peut exprimer une attente esthétique, mais ne précise pas ce que la caméra doit filmer :
Publicité d’une marque prestigieuse de céramique, empreinte de chaleur artisanale, d’une texture extrême, au style cinématographique, en ultra‑haute définition, offrant une présentation spectaculaire du produit.
Si l’objectif est simplement de poser le gobelet, on peut d’abord simplifier la tâche :
Lin He place verticalement le gobelet en céramique rouge ocre sans anse, qu’elle tient dans sa main droite, au centre du plateau en bois. Une fois le fond du gobelet en contact avec le plateau, elle relâche sa main droite et ramène celle‑ci à sa position initiale. La caméra reste fixe, permettant de voir entièrement le gobelet et le plateau.
Faites d’abord que cet événement se produise, puis décidez si vous souhaitez ajouter des nuances d’éclairage, des ambiances sonores ou des détails supplémentaires dans la performance. Les termes stylistiques peuvent être conservés, mais ils ne remplacent pas la description précise des actions.
L’ouverture est déjà bien réglée, mais on exige encore de « poser ».
Supposons que le gobelet illustré soit déjà solidement posé sur le plateau, mais que le prompt demande tout de même « qu’elle pose le gobelet sur le plateau ». Dans ce cas, le modèle devra imaginer lui‑même les gestes nécessaires pour le prendre, le déplacer et le reposer.
Deux options s’offrent à vous : préparer une image initiale montrant le gobelet tenu en main, le plateau vide, et réaliser directement l’action de pose ; ou conserver l’image existante et modifier le prompt en « sa main droite effleure légèrement le gobelet avant de s’en retirer ». Cette dernière approche modifie la tâche originale et ne devrait être utilisée que lorsque vous acceptez un nouveau contenu pour la scène.
Les images de référence et les instructions d’action doivent être cohérentes entre elles. La clarté des matériaux fournis doit être aussi rigoureusement vérifiée que celle des consignes écrites.
Une même scène requiert à la fois une prise de vue fixe, une avancée et un panoramique.
« Prise de vue en position fixe, lent mouvement de la caméra vers l’avant suivi d’un panoramique complet, terminant par un plan plongeant » combine plusieurs types de mouvements et de coupes. Ce type de séquence pourrait convenir à une série multi‑plans spécialement conçue, mais il n’est pas adapté pour servir de premier test d’une action simple comme celle‑ci.
Dans ce cas, commencez par fixer la caméra sur un plan moyen, afin que le gobelet, les mains et le plateau restent constamment visibles. Après validation de cette étape, essayez ensuite une légère avancée ; n’ajoutez pas simultanément zoom, panoramique et plan plongeant dans un même passage.
On a écrit « poser naturellement », mais sans décrire la transition.
Ici, la transition consiste à transférer le soutien du gobelet de la main au plateau. Le prompt pourrait préciser : la main droite saisit la partie inférieure du corps du gobelet, l’orifice étant orienté vers le haut ; une fois le fond en contact avec le plateau, les doigts se détendent ; le gobelet reste sur le plateau, tandis que la main droite s’éloigne.
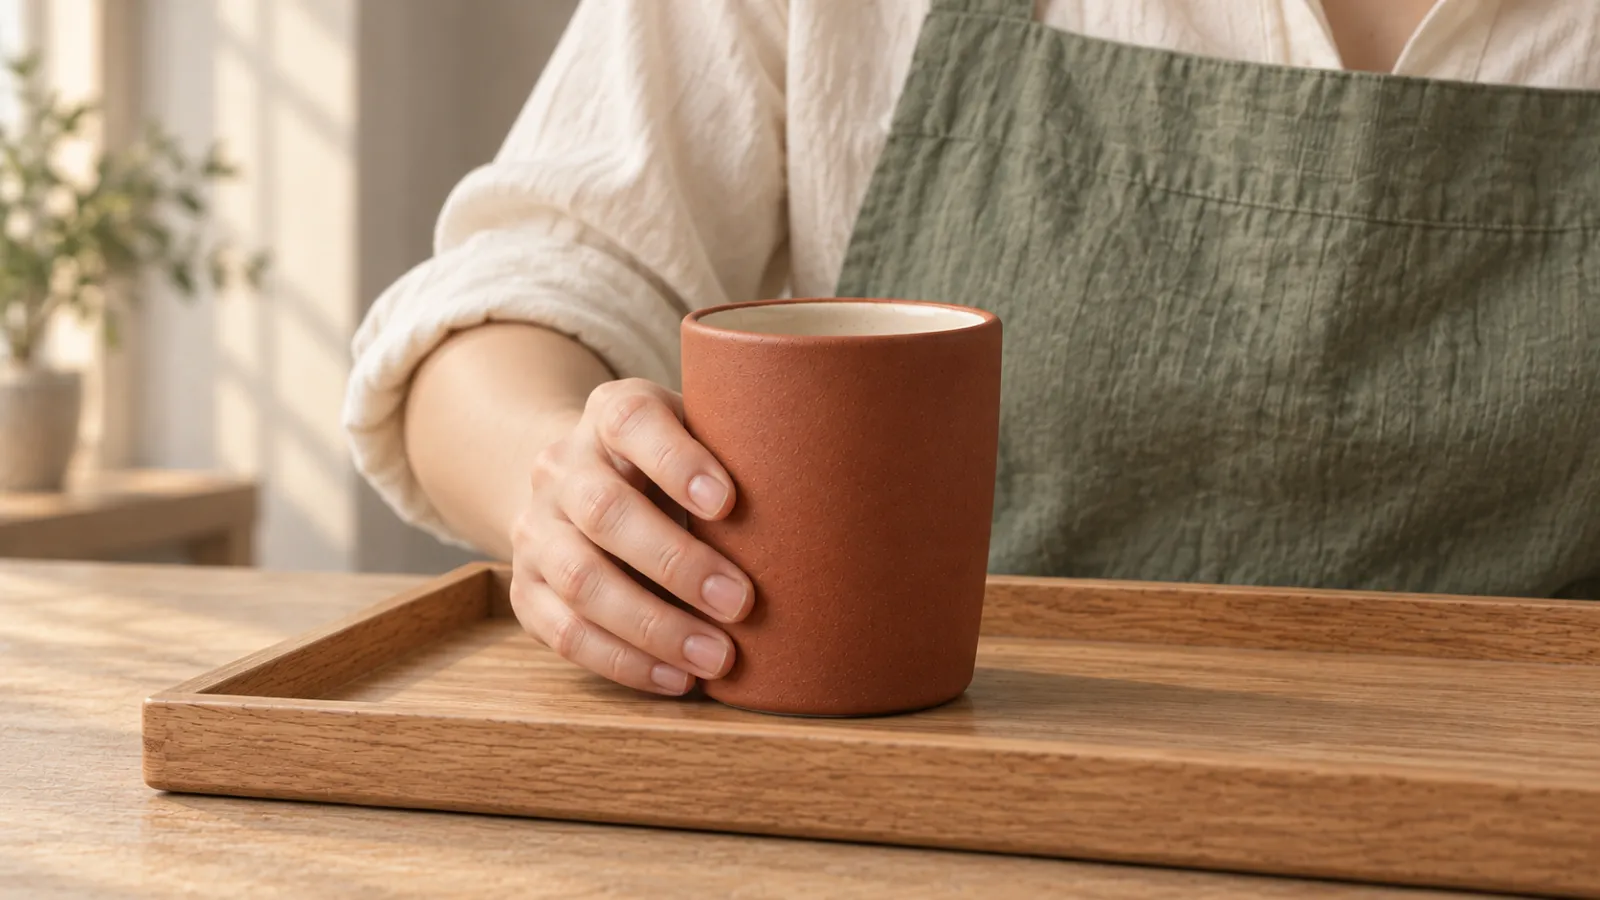
Légende : Schéma de l’état de contact, destiné à illustrer les relations de soutien ; il ne prouve pas que le geste de contact vidéo a bien été réalisé.
Inutile d’exprimer chaque articulation sous forme d’instructions mécaniques complexes. L’essentiel est de savoir qui soutient l’objet à chaque étape, et si la paume et le corps du verre restent deux entités distinctes. En cas d’échec répété, on peut d’abord réduire la distance de déplacement, ou scinder la séquence en deux plans : « plan rapproché du verre tenu » et « moment où le verre est stabilisé ».
Intégrer émotions, lumière et arrière-plan dans le mouvement principal
« Elle pose le verre, joyeuse et pensative, alternant contre-jour et éclairage zénithal ; les accessoires sur l’étagère tournent simultanément, tandis que la caméra traverse rapidement l’atelier », ajoute de nombreuses variations concurrentes.
Pour cette scène, l’interprétation pourrait se limiter à baisser la tête pour regarder le verre, puis expirer doucement après l’avoir posé. La lumière reste celle provenant de la fenêtre gauche, et l’arrière-plan demeure immobile. Il convient d’abord de valider le geste de pose ; les autres éléments doivent chacun avoir une fonction précise.
Modifier tous les paramètres en une seule fois, puis deviner quel élément est efficace
Si, lors de la version précédente, la main était fusionnée, et que dans la suivante on change simultanément la référence, le modèle, le mouvement et le format d’image, même si le résultat s’améliore, il sera difficile d’en identifier la cause.
Il est recommandé de conserver d’abord la version actuelle, puis de modifier uniquement l’élément le plus pertinent. Par exemple, si le verre passe entre les doigts, ajuster d’abord la description de la prise en main ou réduire la distance de déplacement ; si l’apparence du verre est incorrecte dès la première image, vérifier d’abord la référence. À chaque itération, noter les points conservés, ceux modifiés et les observations.
Organiser les cas en prompts directement testables
Voici un point de départ pour créer une vidéo à partir d’une image. Les références concernant les personnages et les objets doivent d’abord être associées selon le mode actuel ; « Lin He » n’est que le nom du cas présenté ici et ne permet pas au modèle d’identifier ce visage.
Utiliser la même céramiste aux cheveux courts déjà associée dans les références, ainsi que le même pot en céramique sans anse, à paroi extérieure ocre et intérieure blanc cassé. Elle porte une chemise blanche à manches courtes, un tablier vert sauge et un pantalon gris foncé.
L’ouverture montre un plan moyen fixe, à hauteur des yeux : elle se tient derrière son établi, tenant la partie inférieure du corps du verre avec la main droite, l’ouverture vers le haut et le fond posé sur un plateau en bois vide. Sa main gauche repose sur la table à côté du plateau, légèrement éloignée de la main droite.
Elle dépose lentement le verre, verticalement, au centre du plateau ; une fois le fond en contact avec le plateau, la main droite se relâche et se retire. Le verre reste droit, le plateau demeure immobile. Elle baisse la tête pour observer le verre, puis expire doucement après le geste.
La caméra reste fixe, le plan moyen conserve intégralement les mains, le verre et le plateau. La séquence se termine sur l’image du verre stabilisé, la main droite déjà retirée.
La lumière provenant de la fenêtre gauche éclaire uniformément le corps du verre, tandis que l’étagère en bois et trois bols en céramique blanc cassé situés à l’arrière droit demeurent immobiles. L’apparence du visage, les vêtements et la couleur ainsi que la forme du verre restent inchangés. L’ensemble constitue une seule séquence continue.
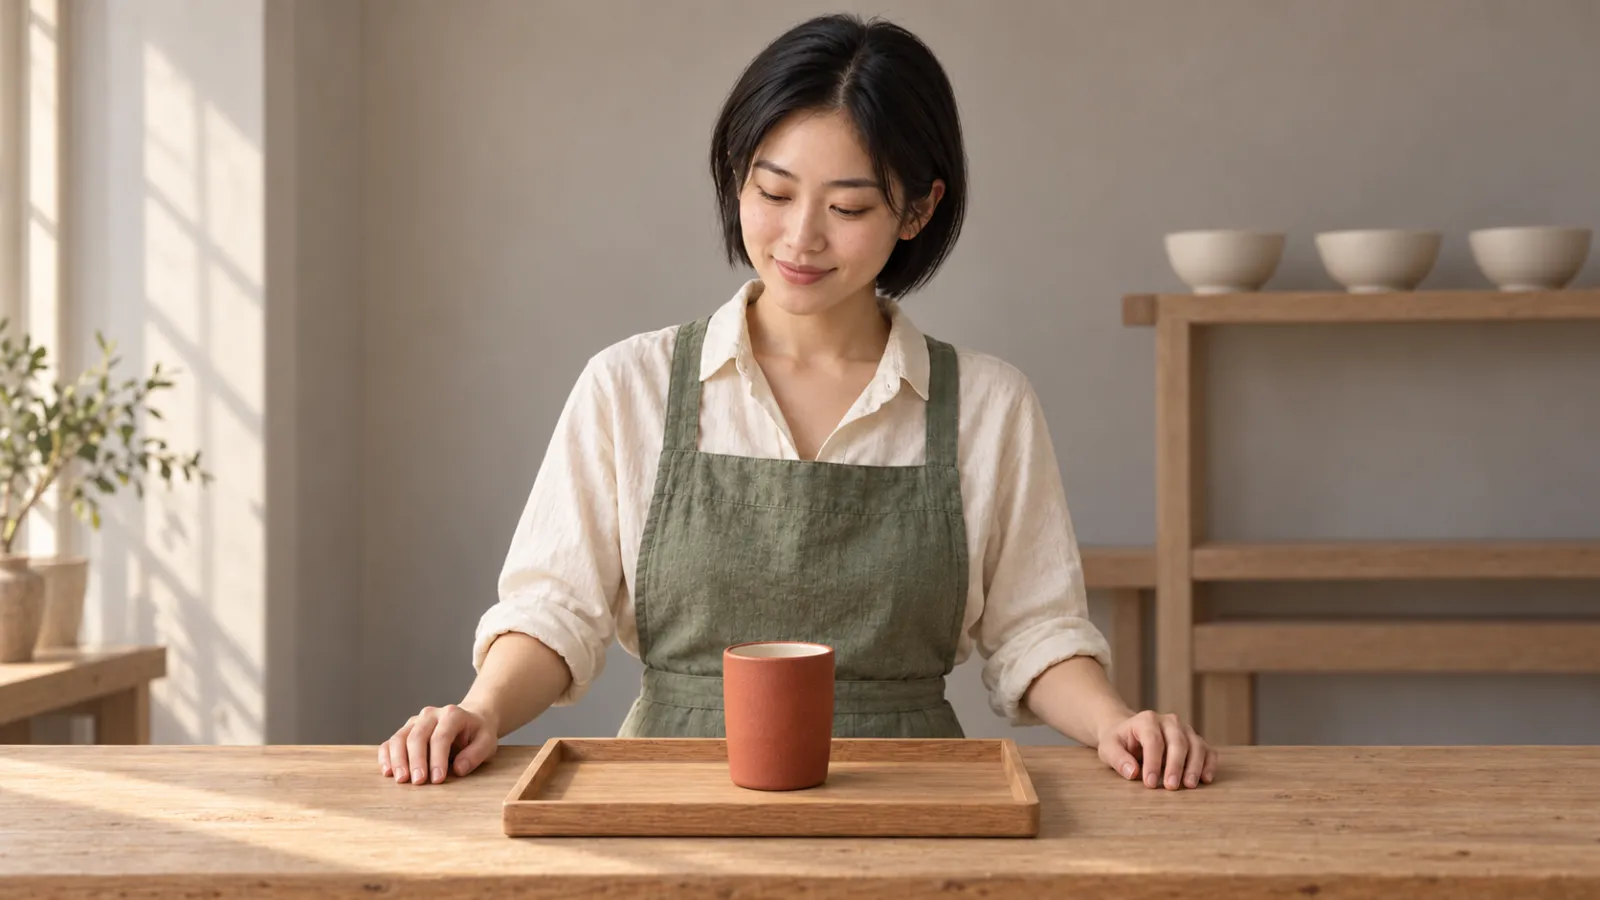
Légende : schéma de la composition finale ; générée séparément de celles du début et du contact, et non issue d’une capture d’écran de la même vidéo.
Ce prompt décrit l’objectif, mais ne garantit pas la génération. Si l’image d’entrée présente déjà clairement l’apparence, on peut réduire les descriptions redondantes de l’apparence et mettre l’accent sur les mouvements et les changements temporels ; si le mode requiert des précisions supplémentaires, il convient de conserver les éléments invariables indispensables.
Les habitudes de formulation des prompts peuvent varier d’un modèle à l’autre.
Tester dans PixPix, en faisant d’abord en sorte qu’une chose soit réalisée
Choisir la méthode de référence, puis sélectionner les spécifications
Ouvrir la plateforme vidéo PixPix pour consulter les modèles et modes d’entrée proposés par le compte actuel, puis télécharger ou associer les ressources nécessaires. Ne pas regrouper indistinctement toutes les images de personnage, d’accessoire et de décor dans une même tâche : définir d’abord quelle image correspond à l’identité fixe, laquelle au verre fixe, et laquelle établit l’image de départ.
La page MiniMax H3 de PixPix présente les entrées textuelles, picturales, vidéo et sonores, distinguant la génération vidéo à partir de texte, les images de début et de fin, ainsi que la référence universelle ; ses instructions officielles recommandent d’utiliser les images de début et de fin pour définir la composition initiale et finale, et la référence universelle pour verrouiller les personnages, les accessoires et le style. La page Seedance 2.5 introduit quant à elle la référence multimodale, ainsi que les capacités d’extension et d’édition des timestamps. Ce sont là les présentations officielles des fonctionnalités, non des comparaisons issues de tests pratiques ; les options réellement disponibles dépendent de la plateforme utilisée.
Pour la première fois, il est possible de choisir la durée relativement courte offerte par le mode actuel, tout en adaptant le format d’image à l’usage final. Vérifier d’abord que le temps accordé à la pose et au relâchement est suffisant, avant d’envisager une histoire plus longue. Avant de soumettre, consulter les spécifications et la consommation affichées sur la plateforme, plutôt que d’estimer le coût actuel sur la base du nombre fixe de points indiqué dans les tutoriels.
Remplacer « je me sens mieux » par une grille d’analyse des mouvements
Lancez la première version de bout en bout, puis mettez en pause pour examiner les trois moments clés : l’ouverture, le contact entre le fond du verre et la surface, ainsi que la fin. Vérifiez la structure à partir d’images fixes, puis effectuez une lecture continue pour contrôler la fluidité des transitions entre les mouvements.
Au début, il n’y a qu’une personne, un verre et un plateau ; le verre est bien tenu dans la main.
Le verre descend depuis la main, sans changement soudain de direction de l’ouverture ni de proportion par rapport au corps du verre.
Le fond du verre touche d’abord le plateau, puis la main droite se relâche ; il n’y a pas de fusion apparente entre la main et le verre.
À la fin, le verre reste sur le plateau, la main droite s’éloigne, et aucune coupure brusque de plan n’apparaît.
Si un point ne passe pas, notez‑le d’abord, sans vous précipiter pour ajouter des détails graphiques. Les défauts qui ne peuvent être corrigés par des ajustements répétés peuvent être contournés en réduisant les masques, en simplifiant les mouvements ou en modifiant la composition de la scène.
Enregistrez la version afin de conserver une preuve permettant la comparaison.
Éléments à noter | Ce qu’il convient de conserver |
|---|---|
Entrée | Fichiers image, utilisations de référence, modes d’entrée |
Paramètres de génération | Modèle, format, durée, résolution et autres paramètres visibles |
Termes de prompt | Texte complet soumis pour cette itération |
Évolution de la version | Ce qui a été modifié par rapport à la version précédente |
Résultats de l’observation | Quel mouvement a réussi, et à quelle étape le défaut est‑il apparu |
Lors de la comparaison entre modèles, essayez d’aligner autant que possible les entrées, les termes de prompt, le format, la durée, la résolution et le nombre de générations communs. Si certaines conditions ne peuvent pas être alignées, indiquez‑les séparément afin d’éviter de classer ensemble des tâches de difficultés différentes.
Questions fréquentes
Plus le terme de prompt est long, plus la vidéo sera précise ?
Pas nécessairement. La longueur ne remplace pas la clarté de la tâche. Commencez par conserver le sujet principal, l’état initial, les mouvements essentiels, le plan et l’état final, puis complétez avec des informations supplémentaires selon les défauts constatés. Les adjectifs redondants qui n’apportent rien au résultat peuvent être supprimés dans un premier temps.
Écrire « pas de déformation, pas de mains supplémentaires » suffira‑t‑il à corriger le problème ?
Cela ne garantit pas forcément la correction. Il est préférable de décrire d’abord l’état souhaité, par exemple : « la main gauche posée à plat sur la table, la main droite relâchée puis ramenée, le verre restant droit », puis d’expliquer, en fonction du modèle actuel, ce qui n’est pas nécessaire. Si le modèle en cours dispose d’un champ spécifique pour les termes négatifs, remplissez‑le selon son usage réel, sans supposer que tous les modèles le supportent.
Pour générer une vidéo à partir d’une image, faut‑il encore décrire l’ensemble de l’image ?
Inutile de répéter mécaniquement. Lorsque l’image fournit déjà l’apparence et la composition, le texte peut se concentrer sur les actions suivantes ; dans le cas de tâches multiples, il convient d’expliquer clairement le rôle de chaque personnage, des accessoires et de l’image initiale. Évitez tout conflit où le matériel indique que la tasse est déjà bien posée, tandis que le texte la fait apparaître en volant depuis loin.
Pourquoi, malgré des instructions claires, l’opération échoue‑t‑elle encore ?
Les mots‑clés ne constituent qu’une partie de l’entrée. La qualité des références, les occlusions, la difficulté des mouvements, les capacités du modèle ainsi que le caractère aléatoire de la génération peuvent tous influencer le résultat. Il n’est pas possible d’attribuer chaque déformation à un mot non mentionné, ni de promettre que l’ajout d’un seul mot suffira à stabiliser le rendu.
Commencez par une modification précise
Accédez à PixPix, la plateforme vidéo, préparez une image de départ qui s’harmonise avec l’action, et commencez par réaliser l’action « poser la tasse de manière stable ». Vérifiez le résultat aux trois étapes — début, contact et fin — puis décidez quel élément modifier dans la version suivante.
Lorsque vous parvenez à identifier clairement quelles exigences sont satisfaites et lesquelles restent insatisfaites, les mots‑clés cessent d’être de simples vœux flous pour devenir des consignes créatives pouvant être ajustées progressivement.
Outil IA d'images pour les équipes e-commerce
Pour les lancements produits, la publicité et les campagnes promotionnelles, utilisez l'IA pour générer des images produit, des visuels de scène, des créations publicitaires et des assets vidéo courts afin de rendre la production de contenu plus efficace.