Häufige Fehler bei KI‑Video‑Prompten: Sechs Kategorien zur Fehlersuche und Methoden zur Anpassung mit PixPix
Die KI‑Video‑Prompt‑Texte sind sehr lang, doch trotzdem werden die Gesichter getauscht, der Becher verformt sich in der Hand, und eine eigentlich gewünschte Bewegung wird in mehrere unzusammenhängende Aufnahmen zerlegt. Wenn man auf solche Probleme stößt, hilft es nicht unbedingt, weiterhin „filmisch“, „ultra‑klar“ und „beste Bildqualität“ hinzuzufügen – das löst oft nicht die eigentlichen Abweichungen.
Ein nützlicherer Ausgangspunkt besteht darin, die Anforderungen in drei Fragen zu zerlegen: In welchem Zustand beginnt das Bild? Was passiert während dieser Zeit nur? Und wie sieht ein zufriedenstellendes Ende aus? Dieses Tutorial verwendet das originäre Beispiel „Ein Töpfer legt eine handgefertigte Tasse auf ein Tablett“, um Sie durch die Überprüfung der Prompt‑Texte, die Vorbereitung von Referenzmaterialien und den Aufbau eines nachvollziehbaren Änderungsprozesses in PixPix zu führen.
Dieser Artikel ist ein Leitfaden zur kreativen Methode. Die dargestellten Figuren und Szenarien sind eigenständige, fiktive Konstruktionen; die Abbildungen dienen lediglich als statische, KI‑generierte Lehrbeispiele. Es wurden keine Video‑Generierungen in PixPix durchgeführt, daher enthält dieser Beitrag weder gemessene Erfolgsquoten, Modell‑Ranglisten noch Garantien für das Ergebnis.
Zunächst prüfen, auf welcher Ebene das Problem auftritt
Verallgemeinern Sie nicht alle Fehlschläge mit der Begründung „der Prompt‑Text ist nicht detailliert genug“. Bei einer deformierten Tasse kann der Grund beispielsweise in einem unscharfen Umriss des Referenzbildes liegen, oder darin, dass die Hand zu stark verdeckt ist, oder auch darin, dass das aktuelle Modell diese Berührungs‑Bewegung schwer bewältigen kann.
Sichtbare Abweichungen | Was zunächst zu überprüfen ist | Nächste Prioritätsmaßnahme |
|---|---|---|
Von Anfang an nicht dieselbe Person oder derselbe Becher | Sind die Referenzmaterialien klar zugeordnet und entsprechen sie einheitlich dem Erscheinungsbild? | Ersetzen Sie die Referenzen durch klare, einheitliche Vorlagen |
Die Figur stimmt, aber die Bewegung passt nicht | Sind Hauptfigur, Startpunkt und Endpunkt klar beschrieben? | Überarbeiten Sie den Bewegungssatz |
Die Tassen‑Bewegung ist bereits korrekt, doch plötzlich wechselt das Bild zu einer neuen Einstellung | Enthält der Prompt‑Text mehrere Kameraeinstellungen oder Zeitabschnitte? | Vereinfachen Sie auf eine einzige, kontinuierliche Einstellung |
Hand und Becher verschmelzen | Griffbereich, Verdeckung und Schwierigkeitsgrad der Bewegung | Reduzieren Sie die Bewegung und verringern Sie die Hand‑Übergänge |
Trotz mehrerer Generierungen treten immer noch dieselben Mängel auf | Stimmen Modell, Eingabemodus und Aufgabe überein? | Probieren Sie andere verfügbare Modi oder ändern Sie die Aufnahmetechnik |
Diese Tabelle gibt die Reihenfolge der Fehlersuche vor, stellt jedoch keine Diagnose der Ursachen dar. Identifizieren Sie zunächst denjenigen Aspekt, der die Nutzung am stärksten beeinträchtigt, und entscheiden Sie dann, ob Sie das Referenzmaterial, den Text oder das Kameradesign anpassen sollten.
Schaffen Sie für das originäre Beispiel einen klaren Ausgangszustand
Fixieren Sie zunächst die Figur und fügen Sie anschließend die Bewegung hinzu.
Die Hauptfigur des Falls heißt „Lin He“ und ist eine fiktive Keramikkünstlerin. Sie trägt kurzes, schwarzes, glattes Haar, ein cremeweißes Baumwollhemd mit umgeschlagenen Ärmeln, eine salbeigrüne Schürze mit Kreuzträgern sowie dunkelgraue lange Hosen; Schmuck trägt sie nicht. Im gesamten Video ist nur sie allein zu sehen.
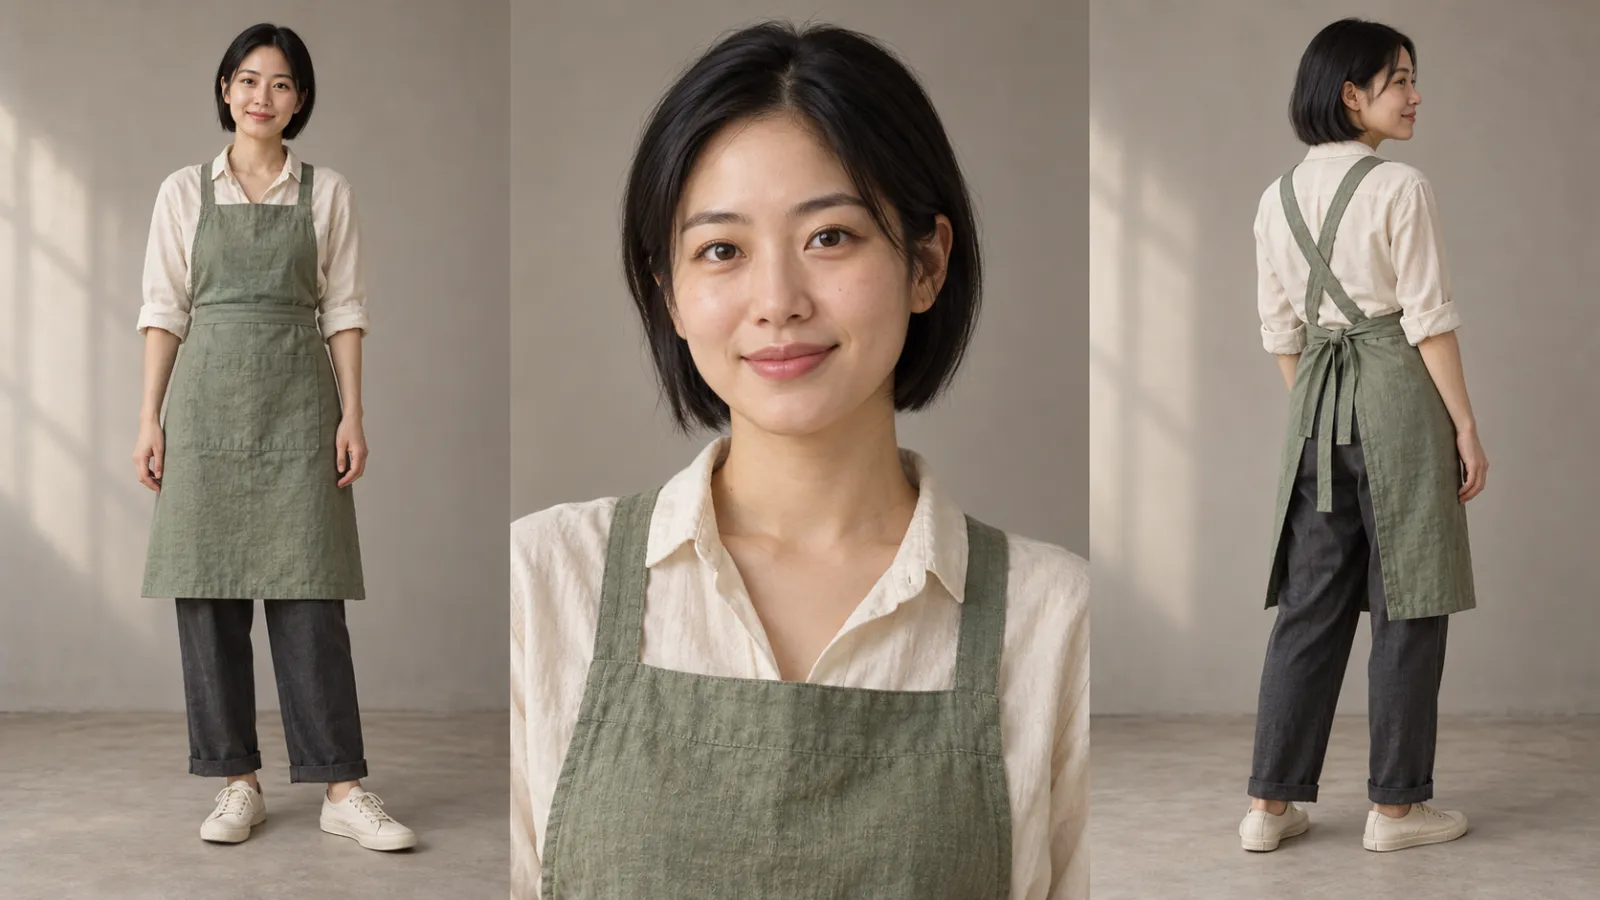
Bildunterschrift: Illustration zur Charakter‑ und Material‑Konzeption; mehrere Ansichten auf einem Board bedeuten nicht, dass gleichzeitig mehrere Personen als Videobestandteil dargestellt werden sollen.
Charakterreferenzen sollten zwei Fragen beantworten: Wer ist das Gesicht und wie sieht die Kleidung aus? Mehransichts‑Konzeptzeichnungen helfen bei der Klärung der Identität, doch beim tatsächlichen Hochladen sollten je nach Anforderungen klare Einzelbilder oder separat eingebundene Referenzen verwendet werden, um zu vermeiden, dass mehrere menschliche Bereiche als mehrere Personen interpretiert werden.
Auch Requisiten müssen eine eindeutige Identität besitzen.
In diesem Fall wird ausschließlich ein griffloses Tonbecher verwendet: außen ockerrot, innen cremeweiß, der Rand etwas dicker, Oberfläche matt. Er wird in die Mitte eines hellen, rechteckigen Eichenholz‑Tabletts gestellt. Das Tablett liegt flach auf der Arbeitsfläche und bleibt während der gesamten Aufnahme unbewegt.
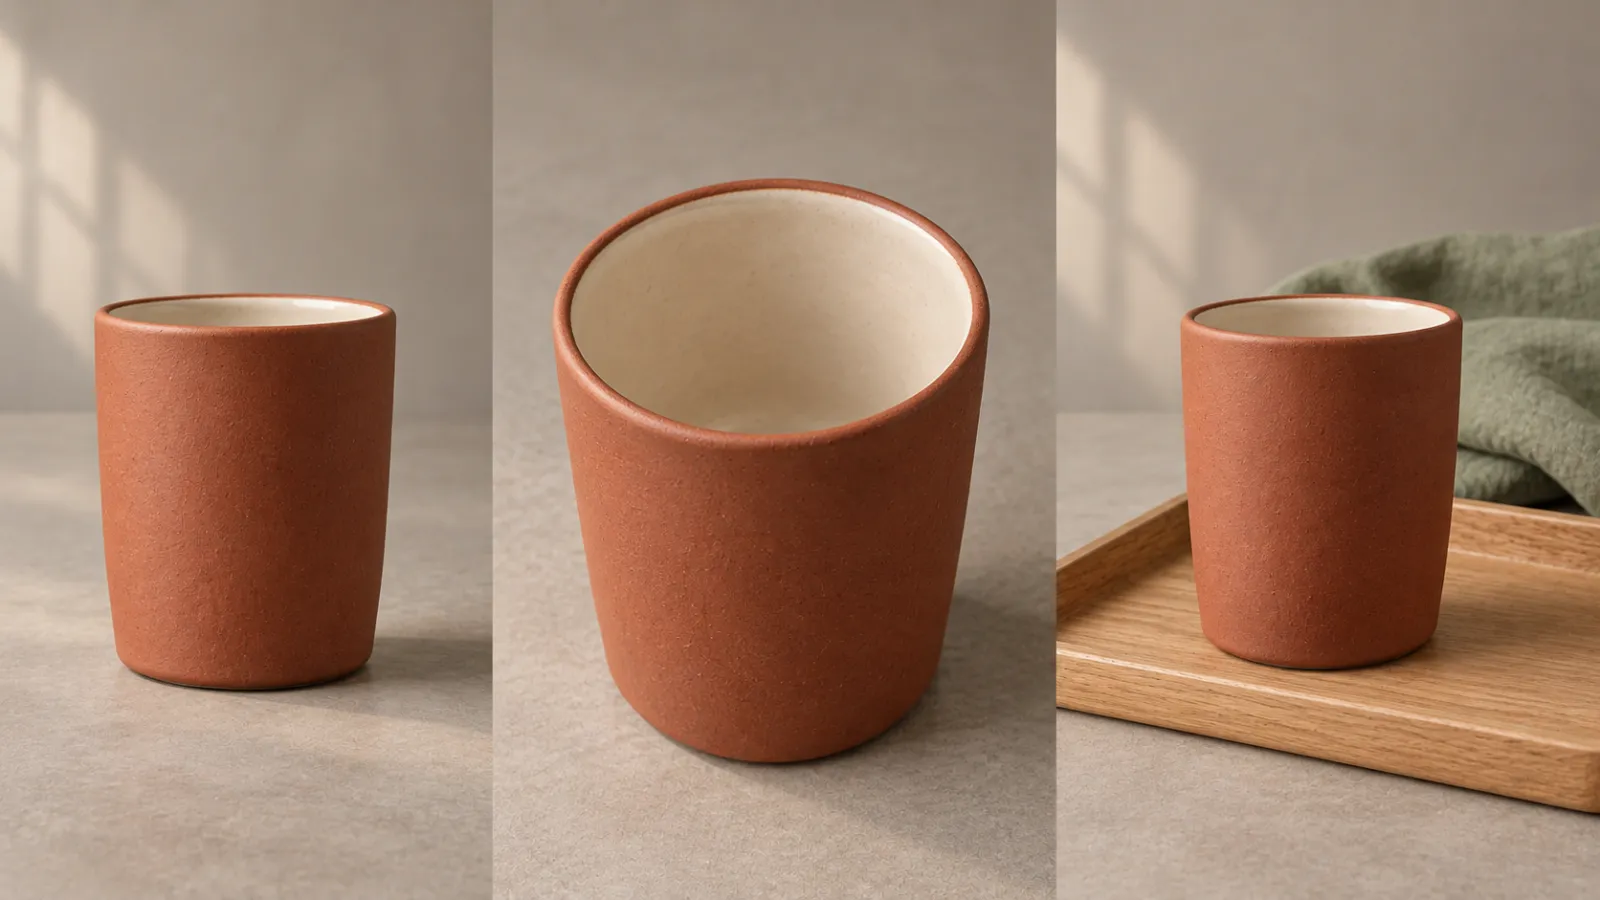
Bildunterschrift: Illustration zur Konzeption eines originalen Requisits – keine Überprüfung der realen Produktstruktur.
Vermeiden Sie es, in einem einzigen Prompt zunächst von einem „Tonbecher“ zu sprechen und später einen „Becher mit Henkel“ in Richtung Kamera zu bewegen. Wenn Form, Farbe oder Oberflächenmuster eines realen Produkts exakt wiedergegeben werden müssen, sollten bestätigte Produktfotos als Grundlage herangezogen werden.
Verwandeln Sie die Szene in eine überprüfbar positionierte Anordnung.
Die Arbeitsfläche befindet sich vor der Figur; das große Fenster liegt links außerhalb des Bildausschnitts der Kamera; ein niedriges Holzregal steht hinten rechts im Hintergrund, darauf stehen lediglich drei cremeweiße Ton‑Schalen. Natürliches Licht fällt von links herein, während rechts sanfte Schatten verbleiben.
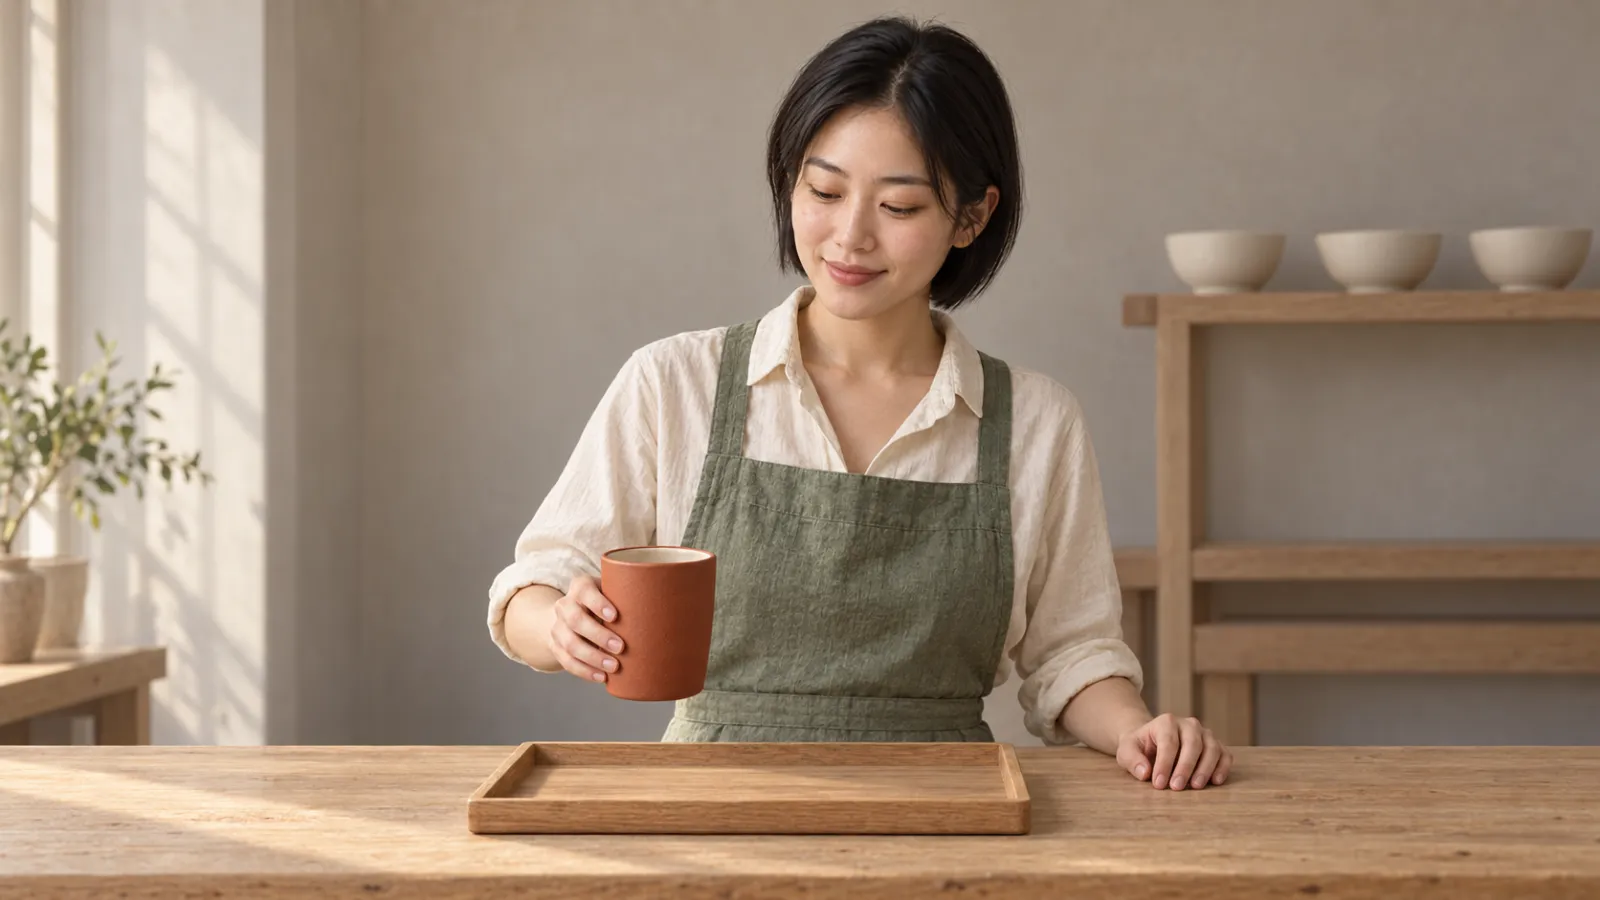
Bildunterschrift: Beispielhafte Darstellung der Ausgangskomposition: Der Becher liegt in der Hand, das Tablett ist leer.
Diese Szene benötigt keine weiteren Dekorationen. Entscheidend ist nicht die detaillierte Beschreibung des gesamten Ateliers, sondern die klare Festlegung jener Objekte, die an der Bewegung beteiligt sind und sowohl Verdeckung als auch Komposition beeinflussen.
Sechs verschiedene Formulierungen, um „den Becher abzustellen“ zu einer anderen Handlung zu machen.
Nur Werbetext ohne sichtbare Bewegung.
Der folgende Text kann ästhetische Erwartungen zum Ausdruck bringen, legt jedoch nicht fest, was genau im Bild erscheinen soll:
Hochwertige Werbung für eine Keramikmarke, voller handwerklicher Wärme, höchster Materialqualität, filmischer Atmosphäre, ultra‑klarer, beeindruckender Produktpräsentation.
Wenn das Ziel lediglich das Abstellen des Bechers ist, lässt sich die Aufgabe zunächst vereinfachen:
Lin He legt den ockerroten, grifflosen Tonbecher, den sie in der rechten Hand hält, senkrecht in die Mitte des Holztablettts. Nachdem der Boden des Bechers das Tablett berührt hat, lässt sie die rechte Hand los und zieht sie zurück. Die Kamera bleibt fixiert und zeigt den Becher sowie das Tablett vollständig.
Lassen Sie diese Handlung zunächst stattfinden und entscheiden Sie erst danach, ob zusätzliche Licht‑ und Schattenebenen, Umgebungsgeräusche oder feinere darstellerische Nuancen hinzugefügt werden sollen. Stilbegriffe können beibehalten werden, übernehmen jedoch nicht die Funktion der Handlungsbeschreibung.
Die Szene wurde bereits festgelegt, dennoch wird „Absetzen“ gefordert.
Angenommen, der im Bild gezeigte Becher steht bereits stabil auf dem Tablett; der Prompt fordert jedoch zusätzlich, dass „sie den Becher auf das Tablett setzt“. In diesem Fall muss das Modell selbst den Vorgang des Aufhebens, Verschiebens und erneuten Absetzens ergänzen.
Es gibt zwei Möglichkeiten: Entweder bereiten Sie ein Startbild vor, auf dem die Person den Becher in der Hand hält und das Tablett leer ist, und führen direkt das Absetzen durch; oder behalten Sie das vorhandene Bild bei und ändern es in „Ihre rechte Hand berührt leicht den Becher und zieht sich dann zurück“. Letzteres verändert die ursprüngliche Aufgabe und sollte nur angewendet werden, wenn Sie neue Bildinhalte akzeptieren.
Referenzbilder und Bewegungsbefehle sollten nahtlos miteinander verbunden sein. Wie klar das Eingabematerial ist, sollte ebenso sorgfältig geprüft werden wie die Klarheit der schriftlichen Anweisungen.
Derselbe Shot verlangt gleichzeitig Fixierung, Annäherung und Rundumschwenk.
„Feststehende Kamera, langsame Annäherung und ein Rundumschwenk, abschließend eine Aufnahme von oben“ enthält mehrere Bewegungs‑ und Schnittanforderungen. Dieser Ansatz eignet sich möglicherweise für eine separat konzipierte Mehrkamera‑Sequenz, ist jedoch ungeeignet als erste Testrunde für diese einfache Bewegung.
In diesem Fall beginnen wir mit einer festen Mittelansicht, sodass Becher, Hände und Tablett stets sichtbar bleiben. Erst nach erfolgreicher Durchführung der Bewegung probieren wir anschließend eine leichte Annäherung aus; Zoom, Rundumschwenk und Aufnahme von oben sollten nicht gleichzeitig in derselben Runde hinzugefügt werden.
„Natürliches Absetzen“ wurde beschrieben, doch die Übergabe wurde nicht näher erläutert.
Hierbei handelt es sich um den Übergang, bei dem die Unterstützung des Bechers von der Hand auf das Tablett übergeht. Der Prompt könnte klar formulieren: Die rechte Hand hält den unteren Teil des Bechers, die Öffnung zeigt nach oben; nachdem der Boden den Teller berührt hat, lassen die Finger los; der Becher bleibt auf dem Tablett, die rechte Hand entfernt sich.
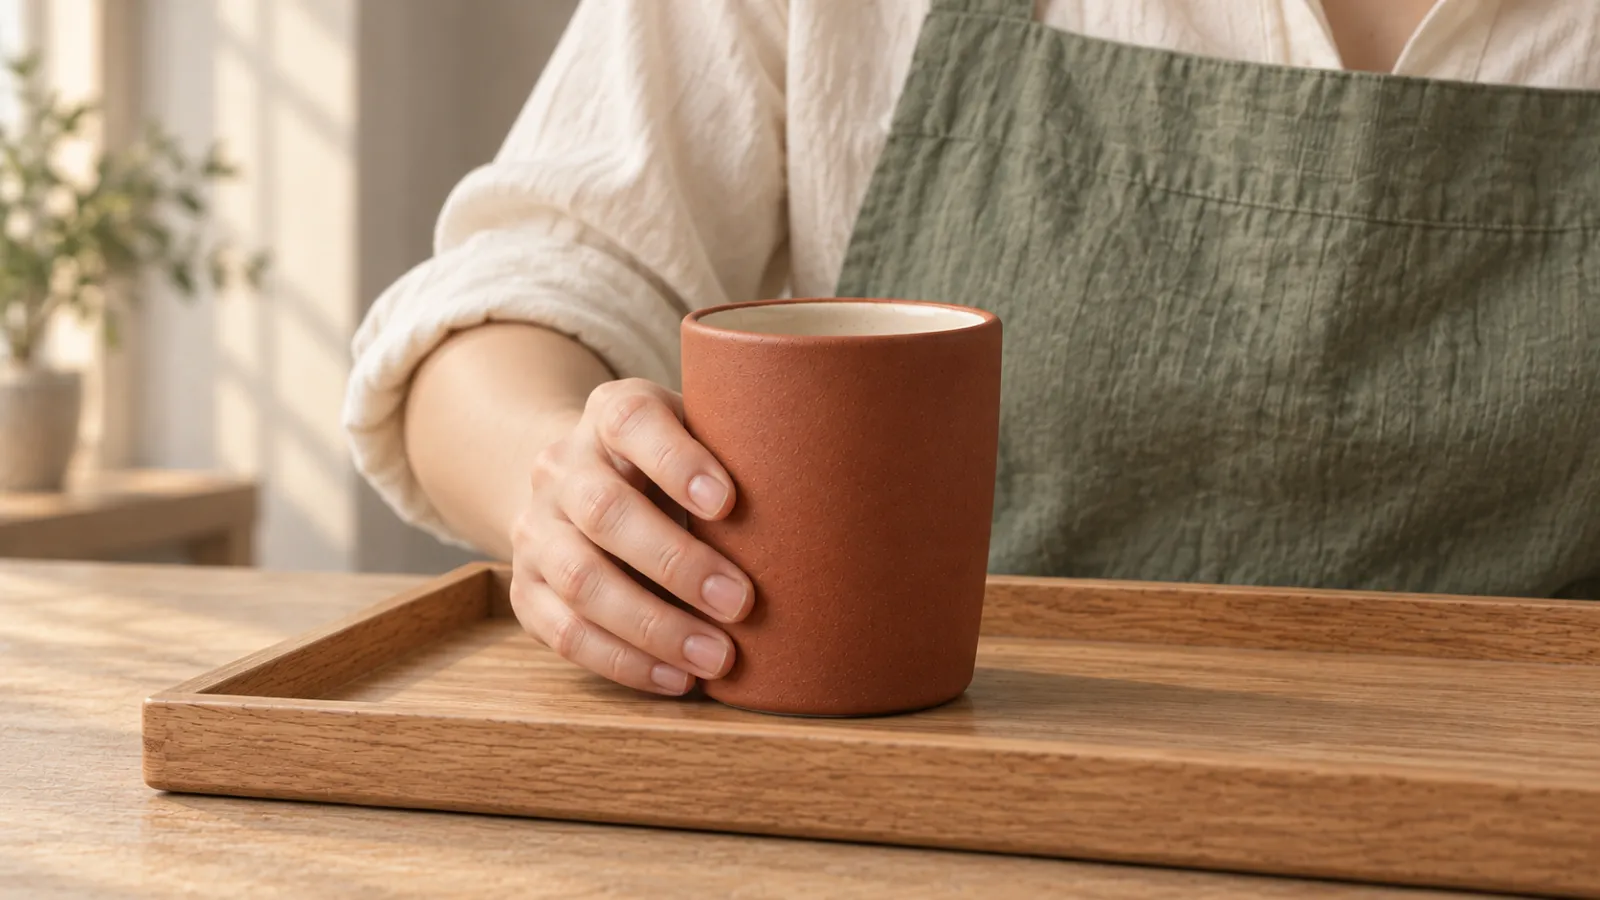
Bildunterschrift: Schematische Darstellung des Kontakts zur Erläuterung der Stützbeziehung; beweist nicht, dass die Videobewegung tatsächlich ausgeführt wurde.
Es ist nicht nötig, jede Gelenkbewegung als komplexen mechanischen Befehl zu formulieren. Der Schwerpunkt liegt darauf, wer in jeder Phase den Gegenstand stützt und ob Handfläche und Becher weiterhin zwei unabhängige Einheiten bleiben. Bei wiederholten Fehlschlägen kann zunächst die Bewegungsstrecke verkürzt oder die Szene in zwei separate Einstellungen unterteilt werden: „Nahaufnahme des Haltens des Bechers“ und „Nach dem sicheren Absetzen des Bechers“.
Emotionen, Licht und Hintergrund vollständig in die Hauptbewegung einbinden
„Sie stellt den Becher glücklich und nachdenklich ab, wobei sich Gegenlicht und Deckenlicht abwechseln, das aufgestellte Requisit gleichzeitig rotiert und die Kamera rasch durch das Studio fährt“, was zahlreiche, sich gegenseitig konkurrierende Veränderungen hinzufügt.
Für diese Einstellung kann die Darbietung auf das leichte Senken des Blicks zum Becher sowie das sanfte Ausatmen nach dem sicheren Absetzen beschränkt werden. Das Licht bleibt auf der linken Fensterseite, der Hintergrund bleibt unbewegt. Zunächst wird nur die Bewegung des Bechers überprüft; alle anderen Änderungen müssen jeweils einen spezifischen Zweck erfüllen.
Alle Bedingungen auf einmal ändern und dann erraten, welche davon wirksam ist
Wenn in der vorherigen Version die Hand mit dem Becher verschmolzen war und in der nächsten Version gleichzeitig Referenzbild, Modell, Bewegung und Bildausschnitt geändert wurden, lässt sich selbst bei einer Verbesserung kaum erkennen, woran es lag.
Es empfiehlt sich, zunächst die aktuelle Version beizubehalten und nur die jeweils relevanteste Komponente zu verändern. Zum Beispiel: Wenn der Becher zwischen den Fingern hindurchgeht, sollte zunächst die Griffbeschreibung angepasst oder die Bewegungsstrecke verkürzt werden; wenn das Aussehen des Bechers bereits vom ersten Frame an fehlerhaft ist, sollte zuerst die Referenz überprüft werden. In jeder Runde werden behaltene Elemente, geänderte Elemente und Beobachtungsergebnisse festgehalten.
Die Fallbeispiele in direkt testbare Prompt‑Texte umwandeln
Im Folgenden finden Sie einen Ausgangspunkt für die Erstellung eines Bild‑zu‑Video‑Werks. Die Referenzen zu Person und Requisiten sollten zunächst gemäß dem aktuellen Schema verknüpft werden; „Lin He“ ist lediglich der Name dieses Beispiels und führt das Modell nicht dazu, dieses Gesicht zu erkennen.
Verwenden Sie dieselbe kurzhaarige Keramikerin aus den bereits verknüpften Referenzen sowie denselben handlosen Tonbecher mit ockerfarbener Außenwand und cremefarbener Innenwand. Sie trägt ein cremefarbenes Hemd mit aufgerollten Ärmeln, eine salbeigrüne Schürze und dunkelgraue lange Hosen.
Der Beginn zeigt eine feste Mittelansicht aus Augenhöhe: Sie steht hinter ihrer Werkbank, hält mit der rechten Hand die untere Hälfte des Bechers, dessen Öffnung nach oben zeigt, während der Boden über einem leeren Holztablett ruht. Die linke Hand liegt auf der Tischplatte neben dem Tablett, getrennt von der rechten Hand.
Langsam setzt sie den Becher senkrecht in die Mitte des Tabletts; sobald der Boden das Tablett berührt, lässt sie die rechte Hand los und zieht sie zurück. Der Becher bleibt aufrecht, das Tablett unverändert an seinem Platz. Sie blickt auf den Becher hinunter und atmet am Ende der Bewegung leicht aus.
Die Kamera bleibt fixiert, die Mittelansicht bewahrt Hände, Becher und Tablett vollständig. Das Ende verweilt auf dem Moment, in dem der Becher stabil abgestellt ist und die rechte Hand bereits entfernt wurde.
Das Seitenfenster beleuchtet den Becher gleichmäßig, während das hölzerne Regal rechts hinten und drei cremefarbene Ton-Schalen unverändert an ihrem Platz bleiben. Das Gesicht, die Kleidung und die Farbe sowie Form des Bechers bleiben konstant. Die gesamte Sequenz ist eine einzige, zusammenhängende Einstellung.
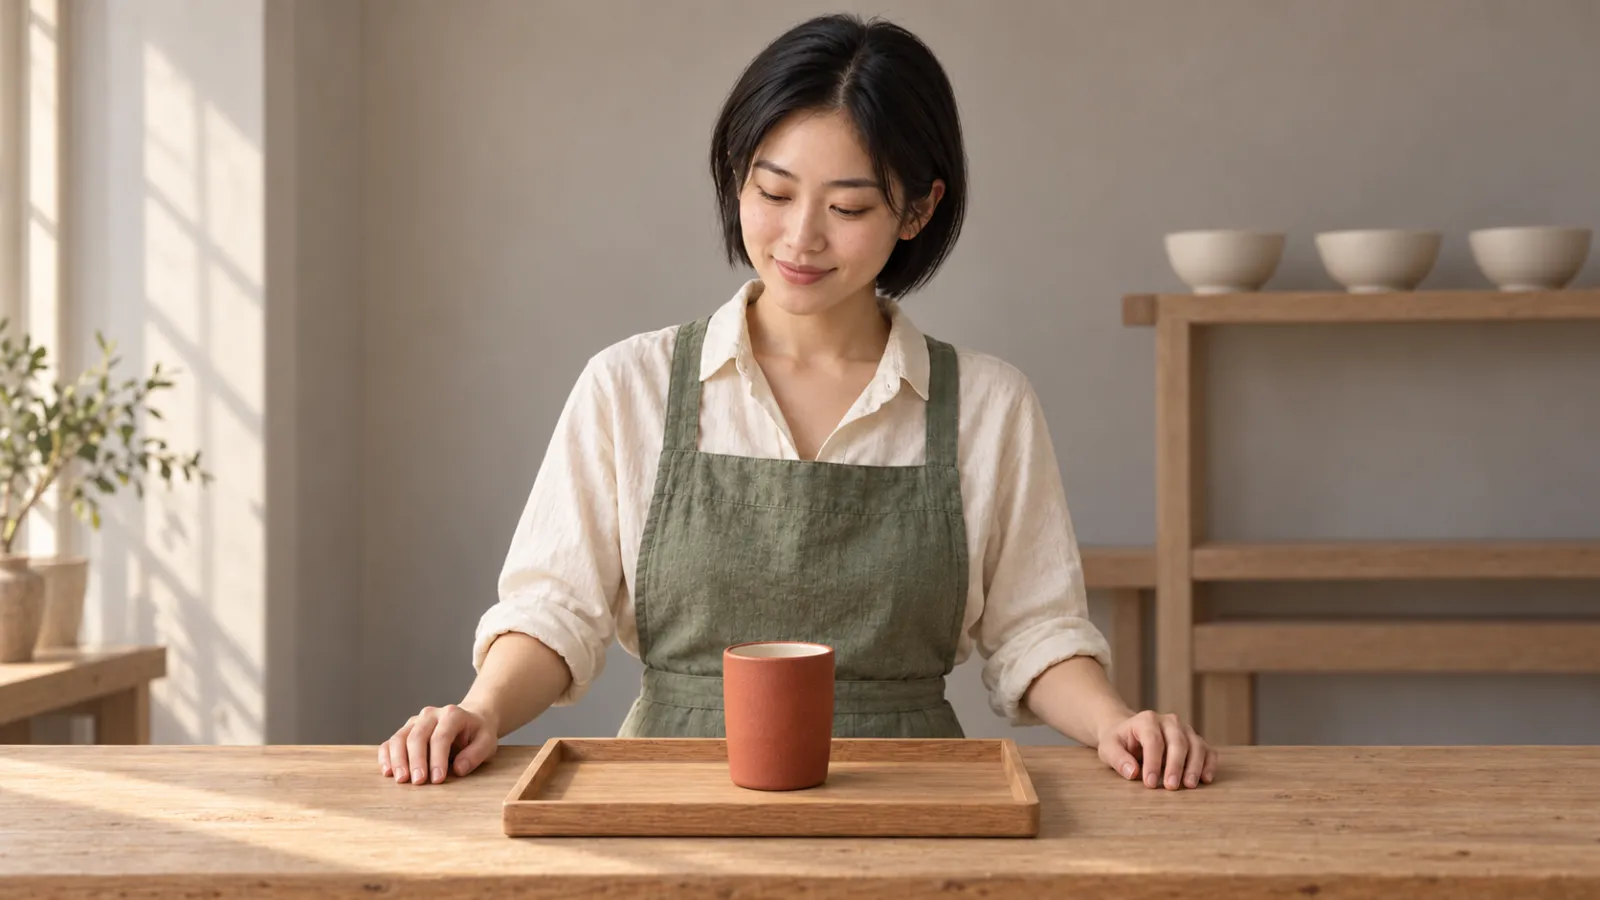
Bildunterschrift: Schematische Darstellung der Endkomposition; entsteht separat von Anfangs‑ und Kontakt‑Diagrammen und ist kein einzelnes Standbild aus dem Video.
Dieser Prompt beschreibt das Ziel, nicht die Garantie für die Erzeugung. Wenn das aktuelle Eingabebild bereits das Aussehen klar darstellt, kann die wiederholte Beschreibung des Aussehens reduziert werden, sodass der Schwerpunkt auf Bewegung und zeitliche Veränderungen gelegt wird; falls das Modell zusätzliche Referenzangaben benötigt, bleiben die notwendigen invarianten Elemente erhalten.
Die Prompt‑Gewohnheiten verschiedener Modelle können ebenfalls unterschiedlich sein.
Testen Sie in PixPix, indem Sie zunächst eine Sache sicherstellen
Wählen Sie zuerst die Referenzmethode, dann die Spezifikationen
Öffnen Sie die PixPix‑Video‑Arbeitsfläche, sehen Sie sich die im aktuellen Account verfügbaren Modelle und Eingabemodi an und laden Sie anschließend Materialien hoch oder verknüpfen Sie sie. Stapeln Sie nicht ohne Unterschied alle Personen‑, Requisiten‑ und Hintergrundbilder in einer einzigen Aufgabe: Legen Sie zunächst klar fest, welches Bild die Identität festlegt, welches den Becher definiert und welches die Startszene bestimmt.
Auf der MiniMax H3‑Seite von PixPix werden Text-, Bild-, Video- und Audioeingaben vorgestellt und zwischen Text‑zu‑Video, Anfangs‑ und End‑Frames sowie All‑Round‑Referenzen unterschieden; die offizielle Erklärung legt den Schwerpunkt auf Anfangs‑ und End‑Frames zur Festlegung von Start‑ und Endkomposition sowie auf All‑Round‑Referenzen zur Fixierung von Personen, Requisiten und Stil. Die Seedance 2.5‑Seite hingegen stellt multimodale Referenzen sowie Möglichkeiten zur Verlängerung und Zeitstempelbearbeitung vor. Dies sind offizielle Angaben zu den Funktionen, keine in diesem Artikel vorgenommenen Vergleiche; die tatsächlich nutzbaren Optionen richten sich nach der Arbeitsfläche.
Beim ersten Mal kann man die kürzere Dauer wählen, die der aktuellen Modusvariante angeboten wird, und dabei das Format entsprechend dem späteren Verwendungszweck abstimmen. Prüfen Sie zunächst, ob sowohl das Absetzen als auch das Loslassen ausreichend Zeit bieten, bevor Sie längere Geschichten in Betracht ziehen. Überprüfen Sie vor dem Absenden die im Arbeitsbereich angegebenen Spezifikationen und den Verbrauch – verlassen Sie sich nicht auf die festen Punktzahlen aus den Anleitungen, um die aktuellen Kosten abzuschätzen.
Verwende eine Bewegungs‑Checkliste anstelle von „Fühlt sich besser an“.
Spiele die erste Version von Anfang bis Ende ab und pausiere anschließend, um die drei Schlüsselpositionen – den Beginn, den Moment des Becherbodens auf der Unterlage sowie das Ende – zu überprüfen. Prüfe die Struktur anhand statischer Frames und überprüfe die fließenden Übergänge durch fortlaufende Wiedergabe.
Zu Beginn sind nur eine Person, ein Becher und ein Tablett zu sehen; der Becher befindet sich tatsächlich in der Hand.
Der Becher bewegt sich von der Hand nach unten, wobei sich die Ausrichtung des Becherrandes und das Verhältnis zum Becherkörper nicht plötzlich verändern.
Zuerst berührt der Becherboden das Tablett, danach lässt die rechte Hand los; es gibt keine sichtbare Verschmelzung zwischen Hand und Becherkörper.
Am Ende bleibt der Becher auf dem Tablett liegen, die rechte Hand löst sich, und es erfolgt kein plötzlicher Kamerawechsel.
Wenn ein Punkt nicht bestanden wird, notiere ihn zunächst – eile nicht, um zusätzliche künstlerische Details hinzuzufügen. Mängel, die sich durch wiederholtes Anpassen nicht beheben lassen, können umgangen werden, indem man die Sichtbehinderung verringert, die Bewegung verkleinert oder die Kameraeinstellung ändert.
Speichere die Version und hinterlasse vergleichbare Nachweise.
Notizpunkte | Was sollte dokumentiert werden? |
|---|---|
Eingaben | Bilddateien, verschiedene Referenzzwecke, Eingabemodi |
Generierungseinstellungen | Modell, Bildformat, Dauer, Auflösung sowie weitere sichtbare Einstellungen |
Prompt‑Wörter | Vollständiger Text der aktuellen Einreichung |
Änderungen gegenüber der vorherigen Version | Was wurde im Vergleich zur vorherigen Version geändert? |
Beobachtungsergebnisse | Welche Bewegung ist erfolgreich, und an welcher Stelle traten Defekte auf? |
Bei Modellvergleichen sollten gemeinsame Eingaben, Prompts, Bildformate, Dauer, Auflösung und generierte Mengen möglichst übereinstimmen. Für Bedingungen, die nicht übereinstimmen, sind gesonderte Erklärungen erforderlich, um zu vermeiden, dass Aufgaben unterschiedlicher Schwierigkeit miteinander verglichen werden.
Häufig gestellte Fragen
Je länger der Prompt, desto präziser das Video?
Nicht unbedingt. Länge ersetzt nicht die Klarheit der Aufgabenstellung. Behalte zunächst das Hauptmotiv, den Ausgangszustand, die Kernbewegung, die Kameraeinstellung und den Endzustand bei und ergänze erst dann Informationen zu konkreten Mängeln. Wiederholende Adjektive, die keinen Nutzen für das Ergebnis bringen, können zunächst entfernt werden.
Kann man mit der Angabe „keine Verformung, keine zusätzlichen Hände“ alles reparieren?
Das garantiert keine Lösung. Beschreibe zunächst den gewünschten Zustand, etwa: „Die linke Hand liegt flach auf dem Tisch, die rechte Hand löst sich und zieht sich zurück, während der Becher aufrecht bleibt“, und ergänze dann entsprechend dem aktuellen Modell, was nicht benötigt wird. Wenn das aktuelle Modell über ein eigenes Feld für negative Hinweise verfügt, fülle dieses gemäß seiner tatsächlichen Verwendung aus – ohne anzunehmen, dass alle Modelle dies unterstützen.
Muss man beim Erzeugen eines Videos aus einem Bild das gesamte Bild erneut beschreiben?
Es ist nicht nötig, sich mechanisch zu wiederholen. Wenn das Bild bereits Aussehen und Komposition liefert, kann der Text sich auf die nachfolgenden Handlungen konzentrieren; bei mehreren Referenzaufgaben gilt es, die Rollen von Charakteren, Requisiten und dem Anfangsbild klar zu definieren. Vermeiden Sie Konflikte, etwa wenn das Material angibt, dass der Becher bereits stabil steht, der Text jedoch behauptet, er fliege aus der Ferne herein.
Warum scheitert das System trotz klar formulierter Anweisungen?
Die Eingabeaufforderung ist nur ein Teil der Eingabe. Die Qualität der Referenzbilder, Verdeckungen, die Schwierigkeit der Bewegungen, die Leistungsfähigkeit des Modells sowie die Zufälligkeit der Generierung können das Ergebnis beeinflussen. Man darf nicht jede Abweichung darauf zurückführen, dass ein bestimmtes Wort fehlt, und man kann auch nicht versprechen, dass das Hinzufügen eines einzelnen Wortes alles stabilisiert.
Beginnen Sie mit einer klaren Änderung
Gehen Sie zu PixPix‑Video‑Arbeitsfläche, bereiten Sie ein Startbild vor, das nahtlos an die Bewegung anschließt, und erledigen Sie zunächst den Schritt „Den Becher sicher abstellen“. Prüfen Sie das Ergebnis anhand der drei Punkte Einstieg, Berührung und Abschluss, bevor Sie entscheiden, was in der nächsten Version genau geändert werden soll.
Wenn Sie klar benennen können, welche Anforderungen erfüllt sind und welche noch nicht, verwandelt sich die Eingabeaufforderung von einem vagen Wunsch in eine schrittweise überarbeitbare kreative Anleitung.
KI-Bildtool für E-Commerce-Teams
Für Produkteinführungen, Werbung und Marketingkampagnen: Erstellen Sie mit KI Produktbilder, Szenenbilder, Werbemotive und Kurzvideo-Assets und machen Sie die Content-Produktion effizienter.